A user-friendly wrapper around MCA, made to
work with ggfacto functions like ggmca, interpret and
hierarchical_clust. Variables are selected the way of the `tidyverse`, as in
tabxplor::tab(). Supplementary variables are not given here: they are added afterwards,
in ggmca.
`MCA2()` keeps the fit of ggfacto 0.3.2, on the individuals: `$ind` has one row per analysed row, so that `FactoMineR::HCPC()` of it classifies the individuals, in their order. It gives the same graphs, tables and clusters as `multiple_correspondence_analysis()`, more slowly on large data, and will be deprecated.
Usage
multiple_correspondence_analysis(
  data,
  active_vars,
  wt,
  excl = NA,
  ncp = Inf,
  graph = FALSE,
  filter,
  ...
)

MCA2(data, active_vars, wt, excl = NA, ncp = Inf, graph = FALSE, filter, ...)
Arguments
- data
The data frame. To analyse a subset of the population, give the whole data frame and `filter`, or filter it inside the call with the native pipe, `data |> dplyr::filter(...) |> multiple_correspondence_analysis(...)`: the analysis then remembers which rows it used, so that
ggmca,hierarchical_clustoris_in_analysiscan be given the whole data frame afterwards.- active_vars
<tidy-select> The active variables.
- wt
<tidy-select> The weight variable, if any.
- excl
The levels to exclude from the calculation of the axes (specific multiple correspondence analysis), matched exactly by name. The missing values of each active variable become a level named `<VAR>.NA`, and `NA`, the default, excludes all of them: `excl = NA` for missing values only, `excl = c(NA, "Other")` to exclude a level too, `excl = "DIPLOMA.NA"` for the missing values of one variable only, `excl = NULL` to keep every level.
- ncp
The number of axes to keep. All of them by default: the eigenvalue table is how one chooses how many axes to interpret, and a truncated one cannot show the drop — it also renormalises Benzecri's modified rate over the axes it kept, so the same axis gets a different rate. To cluster on the first axes, give
hierarchical_clustits own `ncp`.- graph
By default no graph is made, since the result can be plotted with
ggfacto.- filter
A condition on the rows of `data`, as in
dplyr::filter(): only the rows where it is `TRUE` are analysed (`filter = AGE >= 18`).- ...
Additional arguments to pass to
MCA, except those that index its rows or columns (`ind.sup`, `quali.sup`, `quanti.sup`, `tab.disj`).
Value
A `MCA` object from FactoMineR, fitted on the distinct answer profiles (the
combinations of active answers), each weighted by its individuals: the eigenvalues and every
result on the levels are the individuals', and `$ind` has one row per profile (per individual
with `MCA2()`). Use axis_coord and hierarchical_clust to write
coordinates and clusters into the data frame (`FactoMineR::HCPC()` would cluster the profiles).
One more element, `source`, records for each row of `data` its row of `$ind` (`NA` if it was not
analysed) and its weight.
Examples
data(tea, package = "FactoMineR")
res.mca <- multiple_correspondence_analysis(tea, 1:18)
interpret(res.mca) # the eigenvalues, then the axes
#> <div class="tx-scrollbox"><table class="tabxplor-tab" data-quarto-disable-processing="true"><thead><tr><th class="tx-l tx-br tx-bl" rowspan="2"></th><th class="tx-l tx-bl tx-rv" rowspan="2">Question</th><th class="tx-r tx-num tx-br">contrib</th><th class="tx-l tx-br tx-bl" rowspan="2">Positive_levels</th><th class="tx-r tx-num tx-br"> </th><th class="tx-l tx-br tx-bl" rowspan="2">Negative_levels</th><th class="tx-r tx-num tx-br"> </th></tr><tr><th class="tx-r tx-num tx-br tx-unit"><col%></th><th class="tx-r tx-num tx-br tx-unit"><col%></th><th class="tx-r tx-num tx-br tx-unit"><col%></th></tr></thead><tbody><tr><td class="tx-l tx-br tx-bl tx-lbl tx-vname tx-b tx-nb" rowspan="13">Axe 1: 9.9% of variance (mod. 55%)</td><td class="tx-l tx-bl tx-rv">where</td><td class="tx-r tx-num tx-br g2">15.7%</td><td class="tx-l tx-br tx-bl">chain store+tea shop</td><td class="tx-r tx-num tx-br p3 tx-b">11.3%</td><td class="tx-l tx-br tx-bl">chain store</td><td class="tx-r tx-num tx-br m1 tx-b">4.4%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">tearoom</td><td class="tx-r tx-num tx-br g2">13.9%</td><td class="tx-l tx-br tx-bl">tearoom</td><td class="tx-r tx-num tx-br p3 tx-b">11.2%</td><td class="tx-l tx-br tx-bl">Not.tearoom</td><td class="tx-r tx-num tx-br m1 tx-b">2.7%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">how</td><td class="tx-r tx-num tx-br g2">11.2%</td><td class="tx-l tx-br tx-bl">tea bag+unpackaged</td><td class="tx-r tx-num tx-br p2 tx-b">6.8%</td><td class="tx-l tx-br tx-bl">tea bag</td><td class="tx-r tx-num tx-br m1 tx-b">4.3%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">friends</td><td class="tx-r tx-num tx-br g2">9.1%</td><td class="tx-l tx-br tx-bl">friends</td><td class="tx-r tx-num tx-br p1 tx-b">3.2%</td><td class="tx-l tx-br tx-bl">Not.friends</td><td class="tx-r tx-num tx-br m2 tx-b">6.0%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">resto</td><td class="tx-r tx-num tx-br g2">8.5%</td><td class="tx-l tx-br tx-bl">resto</td><td class="tx-r tx-num tx-br p2 tx-b">6.3%</td><td class="tx-l tx-br tx-bl">Not.resto</td><td class="tx-r tx-num tx-br m1 tx-b">2.2%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">price</td><td class="tx-r tx-num tx-br g2">8.1%</td><td class="tx-l tx-br tx-bl">p_variable</td><td class="tx-r tx-num tx-br p1 tx-b">3.5%</td><td class="tx-l tx-br tx-bl">p_branded</td><td class="tx-r tx-num tx-br m1 tx-b">3.0%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">tea.time</td><td class="tx-r tx-num tx-br g2">7.2%</td><td class="tx-l tx-br tx-bl">tea time</td><td class="tx-r tx-num tx-br p1 tx-b">3.1%</td><td class="tx-l tx-br tx-bl">Not.tea time</td><td class="tx-r tx-num tx-br m1 tx-b">4.1%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">pub</td><td class="tx-r tx-num tx-br g2">5.5%</td><td class="tx-l tx-br tx-bl">pub</td><td class="tx-r tx-num tx-br p1 tx-b">4.4%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br g1"></td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">work</td><td class="tx-r tx-num tx-br g2">4.2%</td><td class="tx-l tx-br tx-bl">work</td><td class="tx-r tx-num tx-br p1 tx-b">3.0%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br g1"></td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">How</td><td class="tx-r tx-num tx-br g2">3.9%</td><td class="tx-l tx-br tx-bl">other</td><td class="tx-r tx-num tx-br p1 tx-b">2.3%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br g1"></td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">Tea</td><td class="tx-r tx-num tx-br g2">3.4%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br g1"></td><td class="tx-l tx-br tx-bl">green</td><td class="tx-r tx-num tx-br m1 tx-b">3.0%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">lunch</td><td class="tx-r tx-num tx-br g2">2.8%</td><td class="tx-l tx-br tx-bl">lunch</td><td class="tx-r tx-num tx-br p1 tx-b">2.4%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br g1"></td></tr>
#> <tr class="tx-b tx-bt tx-bb tx-bb2"><td class="tx-l tx-bl tx-rv">Above mean ctr</td><td class="tx-r tx-num tx-br tx-b">87.0%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br tx-b">57.3%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br tx-b">29.6%</td></tr>
#> <tr><td class="tx-l tx-br tx-bl tx-lbl tx-vname tx-b tx-nb" rowspan="5">Axe 2: 8.1%<br>of variance<br>(mod. 28%)</td><td class="tx-l tx-bl tx-rv">where</td><td class="tx-r tx-num tx-br g2">28.6%</td><td class="tx-l tx-br tx-bl">tea shop</td><td class="tx-r tx-num tx-br p4 tx-b">23.9%</td><td class="tx-l tx-br tx-bl">chain store</td><td class="tx-r tx-num tx-br m2 tx-b">4.6%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">price</td><td class="tx-r tx-num tx-br g2">25.6%</td><td class="tx-l tx-br tx-bl">p_upscale</td><td class="tx-r tx-num tx-br p3 tx-b">20.5%</td><td class="tx-l tx-br tx-bl">p_branded</td><td class="tx-r tx-num tx-br m1 tx-b">2.5%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">how</td><td class="tx-r tx-num tx-br g2">23.4%</td><td class="tx-l tx-br tx-bl">unpackaged</td><td class="tx-r tx-num tx-br p3 tx-b">18.9%</td><td class="tx-l tx-br tx-bl">tea bag</td><td class="tx-r tx-num tx-br m2 tx-b">4.5%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">Tea</td><td class="tx-r tx-num tx-br g2">7.3%</td><td class="tx-l tx-br tx-bl">green</td><td class="tx-r tx-num tx-br p1 tx-b">3.3%</td><td class="tx-l tx-br tx-bl">Earl Grey</td><td class="tx-r tx-num tx-br m1 tx-b">2.4%</td></tr>
#> <tr class="tx-b tx-bt tx-bb tx-bb2"><td class="tx-l tx-bl tx-rv">Above mean ctr</td><td class="tx-r tx-num tx-br tx-b">80.5%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br tx-b">66.6%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br tx-b">13.9%</td></tr>
#> <tr><td class="tx-l tx-br tx-bl tx-lbl tx-vname tx-b tx-nb" rowspan="10">Axe 3: 6.0% of variance (mod.<br>8%)</td><td class="tx-l tx-bl tx-rv">Tea</td><td class="tx-r tx-num tx-br g2">20.5%</td><td class="tx-l tx-br tx-bl">Earl Grey</td><td class="tx-r tx-num tx-br p2 tx-b">5.9%</td><td class="tx-l tx-br tx-bl">black</td><td class="tx-r tx-num tx-br m3 tx-b">14.5%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">breakfast</td><td class="tx-r tx-num tx-br g2">13.3%</td><td class="tx-l tx-br tx-bl">Not.breakfast</td><td class="tx-r tx-num tx-br p2 tx-b">6.4%</td><td class="tx-l tx-br tx-bl">breakfast</td><td class="tx-r tx-num tx-br m2 tx-b">6.9%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">sugar</td><td class="tx-r tx-num tx-br g2">13.0%</td><td class="tx-l tx-br tx-bl">sugar</td><td class="tx-r tx-num tx-br p2 tx-b">6.7%</td><td class="tx-l tx-br tx-bl">No.sugar</td><td class="tx-r tx-num tx-br m2 tx-b">6.3%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">How</td><td class="tx-r tx-num tx-br g2">12.1%</td><td class="tx-l tx-br tx-bl">lemon</td><td class="tx-r tx-num tx-br p1 tx-b">3.1%</td><td class="tx-l tx-br tx-bl">milk</td><td class="tx-r tx-num tx-br m2 tx-b">4.5%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv"></td><td class="tx-r tx-num tx-br g2"></td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br g1"></td><td class="tx-l tx-br tx-bl">other</td><td class="tx-r tx-num tx-br m1 tx-b">3.7%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">home</td><td class="tx-r tx-num tx-br g2">8.3%</td><td class="tx-l tx-br tx-bl">Not.home</td><td class="tx-r tx-num tx-br p2 tx-b">8.0%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br g1"></td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">evening</td><td class="tx-r tx-num tx-br g2">6.6%</td><td class="tx-l tx-br tx-bl">evening</td><td class="tx-r tx-num tx-br p1 tx-b">4.3%</td><td class="tx-l tx-br tx-bl">Not.evening</td><td class="tx-r tx-num tx-br m1 tx-b">2.3%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">friends</td><td class="tx-r tx-num tx-br g2">6.4%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br g1"></td><td class="tx-l tx-br tx-bl">Not.friends</td><td class="tx-r tx-num tx-br m1 tx-b">4.2%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">always</td><td class="tx-r tx-num tx-br g2">6.3%</td><td class="tx-l tx-br tx-bl">always</td><td class="tx-r tx-num tx-br p1 tx-b">4.1%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br g1"></td></tr>
#> <tr class="tx-b tx-bt tx-bb tx-bb2"><td class="tx-l tx-bl tx-rv">Above mean ctr</td><td class="tx-r tx-num tx-br tx-b">80.9%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br tx-b">38.5%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br tx-b">42.3%</td></tr>
#> <tr><td class="tx-l tx-br tx-bl tx-lbl tx-vname tx-b tx-nb" rowspan="11">Axe 4: 5.2% of variance (mod.<br>3%)</td><td class="tx-l tx-bl tx-rv">How</td><td class="tx-r tx-num tx-br g2">21.6%</td><td class="tx-l tx-br tx-bl">milk</td><td class="tx-r tx-num tx-br p2 tx-b">6.6%</td><td class="tx-l tx-br tx-bl">other</td><td class="tx-r tx-num tx-br m3 tx-b">12.5%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">dinner</td><td class="tx-r tx-num tx-br g2">21.0%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br g1"></td><td class="tx-l tx-br tx-bl">dinner</td><td class="tx-r tx-num tx-br m3 tx-b">19.5%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">how</td><td class="tx-r tx-num tx-br g2">13.1%</td><td class="tx-l tx-br tx-bl">unpackaged</td><td class="tx-r tx-num tx-br p2 tx-b">7.2%</td><td class="tx-l tx-br tx-bl">tea bag+unpackaged</td><td class="tx-r tx-num tx-br m2 tx-b">5.6%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">price</td><td class="tx-r tx-num tx-br g2">10.1%</td><td class="tx-l tx-br tx-bl">p_private label</td><td class="tx-r tx-num tx-br p1 tx-b">2.5%</td><td class="tx-l tx-br tx-bl">p_variable</td><td class="tx-r tx-num tx-br m1 tx-b">3.5%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">where</td><td class="tx-r tx-num tx-br g2">7.5%</td><td class="tx-l tx-br tx-bl">tea shop</td><td class="tx-r tx-num tx-br p1 tx-b">3.4%</td><td class="tx-l tx-br tx-bl">chain store+tea shop</td><td class="tx-r tx-num tx-br m1 tx-b">3.8%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">breakfast</td><td class="tx-r tx-num tx-br g2">5.9%</td><td class="tx-l tx-br tx-bl">breakfast</td><td class="tx-r tx-num tx-br p1 tx-b">3.1%</td><td class="tx-l tx-br tx-bl">Not.breakfast</td><td class="tx-r tx-num tx-br m1 tx-b">2.8%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">work</td><td class="tx-r tx-num tx-br g2">4.6%</td><td class="tx-l tx-br tx-bl">work</td><td class="tx-r tx-num tx-br p1 tx-b">3.3%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br g1"></td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">tea.time</td><td class="tx-r tx-num tx-br g2">4.2%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br g1"></td><td class="tx-l tx-br tx-bl">Not.tea time</td><td class="tx-r tx-num tx-br m1 tx-b">2.4%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">always</td><td class="tx-r tx-num tx-br g2">3.5%</td><td class="tx-l tx-br tx-bl">always</td><td class="tx-r tx-num tx-br p1 tx-b">2.3%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br g1"></td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">lunch</td><td class="tx-r tx-num tx-br g2">3.5%</td><td class="tx-l tx-br tx-bl">lunch</td><td class="tx-r tx-num tx-br p1 tx-b">2.9%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br g1"></td></tr>
#> <tr class="tx-b tx-bt tx-bb tx-bb2"><td class="tx-l tx-bl tx-rv">Above mean ctr</td><td class="tx-r tx-num tx-br tx-b">81.5%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br tx-b">31.3%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br tx-b">50.3%</td></tr>
#> <tr><td class="tx-l tx-br tx-bl tx-lbl tx-vname tx-b tx-bb2" rowspan="8">Axe 5: 4.9% of<br>variance (mod. 2%)</td><td class="tx-l tx-bl tx-rv">price</td><td class="tx-r tx-num tx-br g2">24.0%</td><td class="tx-l tx-br tx-bl">p_unknown</td><td class="tx-r tx-num tx-br p3 tx-b">17.3%</td><td class="tx-l tx-br tx-bl">p_variable</td><td class="tx-r tx-num tx-br m2 tx-b">5.1%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">How</td><td class="tx-r tx-num tx-br g2">18.1%</td><td class="tx-l tx-br tx-bl">other</td><td class="tx-r tx-num tx-br p3 tx-b">14.2%</td><td class="tx-l tx-br tx-bl">alone</td><td class="tx-r tx-num tx-br m1 tx-b">2.4%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">lunch</td><td class="tx-r tx-num tx-br g2">13.0%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br g1"></td><td class="tx-l tx-br tx-bl">lunch</td><td class="tx-r tx-num tx-br m3 tx-b">11.1%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">Tea</td><td class="tx-r tx-num tx-br g2">12.2%</td><td class="tx-l tx-br tx-bl">black</td><td class="tx-r tx-num tx-br p1 tx-b">4.2%</td><td class="tx-l tx-br tx-bl">green</td><td class="tx-r tx-num tx-br m2 tx-b">8.0%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">resto</td><td class="tx-r tx-num tx-br g2">10.8%</td><td class="tx-l tx-br tx-bl">resto</td><td class="tx-r tx-num tx-br p2 tx-b">7.9%</td><td class="tx-l tx-br tx-bl">Not.resto</td><td class="tx-r tx-num tx-br m1 tx-b">2.8%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">how</td><td class="tx-r tx-num tx-br g2">7.3%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br g1"></td><td class="tx-l tx-br tx-bl">tea bag+unpackaged</td><td class="tx-r tx-num tx-br m2 tx-b">5.0%</td></tr>
#> <tr><td class="tx-l tx-bl tx-rv">dinner</td><td class="tx-r tx-num tx-br g2">3.5%</td><td class="tx-l tx-br tx-bl">dinner</td><td class="tx-r tx-num tx-br p1 tx-b">3.2%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br g1"></td></tr>
#> <tr class="tx-b tx-bt tx-bb tx-bb2"><td class="tx-l tx-bl tx-rv">Above mean ctr</td><td class="tx-r tx-num tx-br tx-b">81.4%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br tx-b">46.9%</td><td class="tx-l tx-br tx-bl"></td><td class="tx-r tx-num tx-br tx-b">34.5%</td></tr></tbody><tfoot><tr><td colspan="7"><div class="tx-foot">Contribution to the variance of the axis: a level on the positive side, contributing <span class="p1" style="font-weight:bold;">×1</span>; <span class="p2" style="font-weight:bold;">×2</span>; <span class="p3" style="font-weight:bold;">×5</span>; <span class="p4" style="font-weight:bold;">×10</span> the mean contribution; a level on the negative side, contributing <span class="m1" style="font-weight:bold;">×1</span>; <span class="m2" style="font-weight:bold;">×2</span>; <span class="m3" style="font-weight:bold;">×5</span>; <span class="m4" style="font-weight:bold;">×10</span> the mean contribution.<br><b>contrib</b>: the whole question's contribution to the axis</div></td></tr></tfoot></table></div>
#> <div class="tx-scrollbox"><table class="tabxplor-tab" data-quarto-disable-processing="true"><thead><tr><th class="tx-l tx-br tx-bl tx-rv" rowspan="2">Axe</th><th class="tx-r tx-num">eigenvalue</th><th class="tx-r tx-num">% variance</th><th class="tx-r tx-num tx-br">cumul.</th><th class="tx-r tx-num">Benzecri's<br>modified rate</th><th class="tx-r tx-num tx-br">cumul. mod.</th></tr><tr><th class="tx-r tx-num tx-unit"><var></th><th class="tx-r tx-num tx-unit"><col%></th><th class="tx-r tx-num tx-br tx-unit"></th><th class="tx-r tx-num tx-unit"><col%></th><th class="tx-r tx-num tx-br tx-unit"></th></tr></thead><tbody><tr><td class="tx-l tx-br tx-bl tx-rv">Axe 1</td><td class="tx-r tx-num g2">0.148</td><td class="tx-r tx-num g2 tx-bar tx-bar-on" style="--tx-bar:100%">9.9%</td><td class="tx-r tx-num tx-br g2">9.9%</td><td class="tx-r tx-num g2">55.4%</td><td class="tx-r tx-num tx-br g2">55.4%</td></tr>
#> <tr><td class="tx-l tx-br tx-bl tx-rv">Axe 2</td><td class="tx-r tx-num g2">0.122</td><td class="tx-r tx-num g2 tx-bar tx-bar-on" style="--tx-bar:82%">8.1%</td><td class="tx-r tx-num tx-br g2">18.0%</td><td class="tx-r tx-num g2">28.1%</td><td class="tx-r tx-num tx-br g2">83.4%</td></tr>
#> <tr><td class="tx-l tx-br tx-bl tx-rv">Axe 3</td><td class="tx-r tx-num g2">0.090</td><td class="tx-r tx-num g2 tx-bar tx-bar-on" style="--tx-bar:60.7%">6.0%</td><td class="tx-r tx-num tx-br g2">24.0%</td><td class="tx-r tx-num g2">7.6%</td><td class="tx-r tx-num tx-br g2">91.1%</td></tr>
#> <tr><td class="tx-l tx-br tx-bl tx-rv">Axe 4</td><td class="tx-r tx-num g2">0.078</td><td class="tx-r tx-num g2 tx-bar tx-bar-on" style="--tx-bar:52.6%">5.2%</td><td class="tx-r tx-num tx-br g2">29.2%</td><td class="tx-r tx-num g2">3.3%</td><td class="tx-r tx-num tx-br g2">94.3%</td></tr>
#> <tr><td class="tx-l tx-br tx-bl tx-rv">Axe 5</td><td class="tx-r tx-num g2">0.074</td><td class="tx-r tx-num g2 tx-bar tx-bar-on" style="--tx-bar:49.7%">4.9%</td><td class="tx-r tx-num tx-br g2">34.1%</td><td class="tx-r tx-num g2">2.1%</td><td class="tx-r tx-num tx-br g2">96.5%</td></tr>
#> <tr><td class="tx-l tx-br tx-bl tx-rv">Axe 6</td><td class="tx-r tx-num g2">0.071</td><td class="tx-r tx-num g2 tx-bar tx-bar-on" style="--tx-bar:48.1%">4.8%</td><td class="tx-r tx-num tx-br g2">38.9%</td><td class="tx-r tx-num g2">1.6%</td><td class="tx-r tx-num tx-br g2">98.1%</td></tr>
#> <tr><td class="tx-l tx-br tx-bl tx-rv">Axe 7</td><td class="tx-r tx-num g2">0.068</td><td class="tx-r tx-num g2 tx-bar tx-bar-on" style="--tx-bar:45.7%">4.5%</td><td class="tx-r tx-num tx-br g2">43.4%</td><td class="tx-r tx-num g2">1.0%</td><td class="tx-r tx-num tx-br g2">99.1%</td></tr>
#> <tr><td class="tx-l tx-br tx-bl tx-rv">Axe 8</td><td class="tx-r tx-num g2">0.065</td><td class="tx-r tx-num g2 tx-bar tx-bar-on" style="--tx-bar:44.1%">4.4%</td><td class="tx-r tx-num tx-br g2">47.7%</td><td class="tx-r tx-num g2">0.6%</td><td class="tx-r tx-num tx-br g2">99.7%</td></tr>
#> <tr class="tx-bt"><td class="tx-l tx-br tx-bl tx-rv">... of 27</td><td class="tx-r tx-num">...</td><td class="tx-r tx-num">...</td><td class="tx-r tx-num tx-br">...</td><td class="tx-r tx-num">...</td><td class="tx-r tx-num tx-br">...</td></tr>
#> <tr class="tx-bb tx-bb2"><td class="tx-l tx-br tx-bl tx-rv">Total</td><td class="tx-r tx-num g2">1.500</td><td class="tx-r tx-num tx-b">100%</td><td class="tx-r tx-num tx-br tx-b"></td><td class="tx-r tx-num tx-b">100%</td><td class="tx-r tx-num tx-br tx-b"></td></tr></tbody></table></div>
# \donttest{
ggfacto(res.mca, tea, sup_vars = c(sex, SPC)) # the graph, with supplementary variables
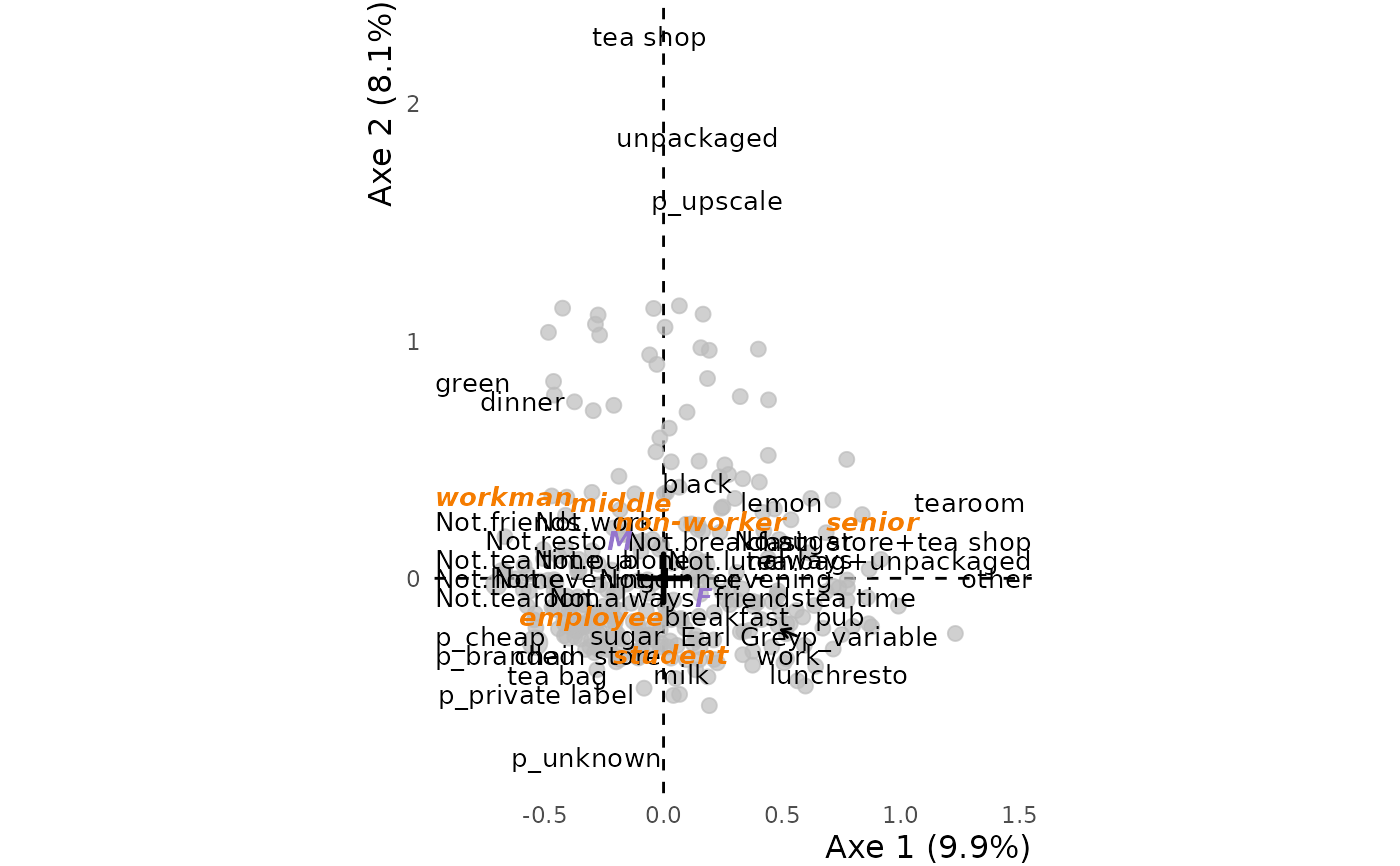 ggfacto(res.mca, tea, sup_vars = c(sex, SPC), interactive = TRUE) # hover: the crosstables
# }
# A subset of the population: the analysis remembers which rows it used
res.mca_young <- tea |>
dplyr::filter(age < 30) |>
multiple_correspondence_analysis(1:18)
# the same analysis
res.mca_young <- multiple_correspondence_analysis(tea, 1:18, filter = age < 30)