Introduction à ggfacto : ACP, AC et ACM au plus près des données
Source:vignettes/articles/ggfacto-fr.Rmd
ggfacto-fr.RmdAn English version of this guide is available: Introduction to ggfacto.
ggfacto dessine les analyses géométriques de données de
FactoMineR pour qu’on les lise sans quitter les
données : au survol d’un point, le graphique interactif affiche
les tableaux croisés dont il est issu, les pourcentages colorés selon
leur écart à la moyenne (bleu pour une sur-représentation, rouge pour
une sous-représentation). Une modalité au bord du nuage se voit donc
aussitôt comme une somme d’écarts, et l’on évite de sur-interpréter la
géométrie.
Les trois analyses s’écrivent de la même façon :
- l’analyse, avec la base de données en premier argument, comme dans
tabxplor::tab(); -
interpret(), le tableau des axes, avec sous lui celui des valeurs propres ; -
ggfacto(), le graphique, queinteractive = TRUErend interactif ; - les classes, écrites dans la base avec
mutate(), décrites parclust_tab().
Une seule option décide de l’affichage de tous les tableaux, ceux de
tabxplor comme ceux de ggfacto :
options(tabxplor.print = "html") les affiche en html, dans
RStudio, Positron ou un document.
Analyse en composantes principales : des moyennes
Une ACP résume des variables numériques. Nous prenons les voitures de
mtcars, décrites par six mesures actives ; le nombre de
cylindres servira de variable supplémentaire.
voitures <- mtcars |> mutate(cyl = factor(cyl))

acp <- principal_component_analysis(voitures, c(mpg, disp, hp, drat, wt, qsec))
interpret(acp)| Variables | Axe 1 | Axe 2 | Axe 3 | |||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| variable | mean | sd | sd/mean | coord | contrib | cos2 | coord | contrib | cos2 | coord | contrib | cos2 |
| <mean> | <sd> | <cv> | <mean> | <col%> | <row%> | <mean> | <col%> | <row%> | <mean> | <col%> | <row%> | |
| mpg | 20.09 | 5.93 | 30% | -0.94 | 21% | 88% | -0.06 | 0% | 0% | -0.11 | 4% | 1% |
| disp | 230.72 | 121.99 | 53% | 0.95 | 22% | 91% | 0.06 | 0% | 0% | 0.06 | 1% | 0% |
| hp | 146.69 | 67.48 | 46% | 0.87 | 18% | 76% | -0.39 | 13% | 15% | 0.08 | 2% | 1% |
| drat | 3.60 | 0.53 | 15% | -0.75 | 13% | 56% | -0.47 | 19% | 22% | 0.46 | 64% | 21% |
| wt | 3.22 | 0.96 | 30% | 0.90 | 19% | 81% | 0.32 | 9% | 10% | 0.24 | 17% | 6% |
| qsec | 17.85 | 1.76 | 10% | -0.52 | 6% | 27% | 0.82 | 58% | 67% | 0.20 | 12% | 4% |
| Total | 100% | 100% | 100% | |||||||||
|
Coordinate on the axis, i.e. its correlation with it : a variable above,
by +0,1 ; +0,2 ; +0,4 ; +0,8 SD ; a variable below, by -0,1 ; -0,2 ; -0,4 ; -0,8 SD.
contrib: its contribution to the variance of the axis; an axis sums to 100 % cos2: quality of representation sd/mean: coefficient of variation – the standard deviation as a percentage of the mean, comparable between variables measured in different units |
||||||||||||
| Variance | |||
|---|---|---|---|
| Axe | eigenvalue | % variance | cumul. |
| <var> | <col%> | ||
| Axe 1 | 4.187 | 69.8% | 69.8% |
| Axe 2 | 1.148 | 19.1% | 88.9% |
| Axe 3 | 0.333 | 5.6% | 94.5% |
| Axe 4 | 0.154 | 2.6% | 97.1% |
| Axe 5 | 0.125 | 2.1% | 99.1% |
| Axe 6 | 0.052 | 0.9% | 100% |
| Total | 6.000 | 100% | |
Le tableau s’ouvre sur ce que sont les variables
avant l’analyse : moyenne, écart-type et
coefficient de variation (sd/mean,
l’écart-type en pourcentage de la moyenne, comparable d’une variable à
l’autre malgré leurs unités). Viennent ensuite, axe par axe, la
coordonnée de chaque variable (sa corrélation avec l’axe, colorée), sa
contribution et sa qualité de représentation (cos2). Le premier axe (70
% de la variance) oppose la cylindrée, la puissance et le poids à la
consommation (mpg) : c’est un facteur de taille. Le second
oppose les voitures lentes à accélérer (qsec) aux
autres.
ggfacto(acp, voitures, sup_vars = cyl, interactive = TRUE)Le graphique superpose les voitures (en gris), les variables actives
(les flèches) et les modalités supplémentaires, au barycentre de leurs
voitures. Au survol, une flèche donne la moyenne et le
coefficient de variation de sa variable ; une modalité supplémentaire,
la moyenne de chaque variable active dans son groupe, colorée selon son
écart à l’ensemble ; une voiture, ses valeurs. Le cercle des
corrélations seul s’obtient avec
ggfacto(acp, profiles = FALSE).
Analyse des correspondances : un tableau croisé
Une AC est l’analyse d’un tableau croisé : on la
calcule donc sur le tableau lui-même. Nous croisons la religion et la
préférence partisane de l’enquête américaine
forcats::gss_cat, sans les non-réponses.
gss <- forcats::gss_cat |>
  filter(!relig %in% c("No answer", "Don't know", "Not applicable"),
         !partyid %in% c("No answer", "Don't know"))

tab(gss, relig, partyid, pct = "row", color = "contrib")| partyid | |||||||||
|---|---|---|---|---|---|---|---|---|---|
| relig | Other party |
Strong republican |
Not str republican |
Ind,near rep | Independent | Ind,near dem |
Not str democrat |
Strong democrat | Total |
| <row%> | <row% (n)> | ||||||||
| Inter-nondenominational | 1% | 13% | 9% | 8% | 26% | 12% | 10% | 20% | 100% ( 108) |
| Native american | 0% | 0% | 4% | 4% | 26% | 17% | 30% | 17% | 100% ( 23) |
| Christian | 3% | 8% | 15% | 10% | 22% | 9% | 18% | 14% | 100% ( 684) |
| Orthodox-christian | 0% | 10% | 12% | 11% | 18% | 15% | 20% | 15% | 100% ( 94) |
| Moslem/islam | 1% | 2% | 3% | 7% | 21% | 19% | 28% | 18% | 100% ( 99) |
| Other eastern | 0% | 6% | 6% | 9% | 38% | 22% | 9% | 9% | 100% ( 32) |
| Hinduism | 0% | 0% | 9% | 3% | 38% | 17% | 26% | 7% | 100% ( 69) |
| Buddhism | 4% | 6% | 3% | 5% | 21% | 27% | 20% | 13% | 100% ( 143) |
| Other | 7% | 3% | 7% | 12% | 22% | 21% | 14% | 15% | 100% ( 221) |
| None | 3% | 3% | 8% | 8% | 28% | 18% | 16% | 16% | 100% ( 3 509) |
| Jewish | 2% | 6% | 10% | 4% | 10% | 14% | 21% | 32% | 100% ( 388) |
| Catholic | 1% | 9% | 14% | 9% | 21% | 11% | 21% | 14% | 100% ( 5 090) |
| Protestant | 1% | 15% | 17% | 8% | 16% | 10% | 16% | 17% | 100% (10 794) |
| Total | 2% | 11% | 14% | 8% | 19% | 12% | 17% | 16% | 100% (21 254) |
| pvalue (Chi2 !) | <0.01% | ||||||||
| Cramér’s V | 0.10 | ||||||||
|
Contribution to Chi2 : cell over-represented vs independence, by ×1 ; ×2 ; ×5 ; ×10 the mean contribution ; cell
under-represented, by ×1 ; ×2 ; ×5 ; ×10 the mean contribution.
|
|||||||||
color = "contrib" colore les cases selon leur
contribution à la variance du tableau — celles qui
pèsent dans l’analyse —, bleu pour une sur-représentation et rouge pour
une sous-représentation.
ac <- correspondence_analysis(tab(gss, relig, partyid))
interpret(ac)| Variable | Positive_levels | Negative_levels | |||
|---|---|---|---|---|---|
| <col%> | <col%> | ||||
|
Axe 1: 76,2% of variance |
relig | None | 55.0% | Protestant | 32.4% |
| relig: above mean ctr | 55.0% | 32.4% | |||
| partyid | Independent | 21.1% | Strong republican | 35.9% | |
| Ind,near dem | 18.3% | Not str republican | 18.0% | ||
| partyid: above mean ctr | 39.4% | 53.9% | |||
|
Axe 2: 10,9% of variance |
relig | Jewish | 43.0% | Catholic | 34.3% |
| relig: above mean ctr | 43.0% | 34.3% | |||
| partyid | Strong democrat | 46.4% | Independent | 17.2% | |
| Other party | 14.3% | ||||
| partyid: above mean ctr | 60.8% | 17.2% | |||
|
Contribution to the variance of the axis : a level on the positive side,
contributing ×1 ;
×2 ; ×5 ; ×10 the mean contribution ; a level on
the negative side, contributing ×1 ; ×2 ; ×5 ; ×10 the mean contribution.
|
|||||
| Axe | eigenvalue | % variance | cumul. |
|---|---|---|---|
| <var> | <col%> | ||
| Axe 1 | 0.049 | 76.2% | 76.2% |
| Axe 2 | 0.007 | 10.9% | 87.1% |
| Axe 3 | 0.005 | 7.5% | 94.6% |
| Axe 4 | 0.002 | 2.7% | 97.3% |
| Axe 5 | 0.001 | 2.0% | 99.4% |
| Axe 6 | 0 | 0.5% | 99.9% |
| Axe 7 | 0 | 0.1% | 100% |
| Total | 0.064 | 100% |
Pour chaque axe, interpret() ne garde que les modalités
qui contribuent plus que la moyenne, face à face selon le signe de leur
coordonnée. Le premier axe (76 % de la variance) oppose les
protestant·es républicain·es aux personnes sans religion, indépendantes
ou proches des démocrates ; le second, les juif·ves et les démocrates
convaincu·es aux catholiques. Une fois les axes interprétés, on les
nomme : les noms s’impriment dans les graphiques et dans les
tableaux.
ac <- name_axes(ac, "protestant·es républicain·es / sans religion",
                    "catholiques / juif·ves démocrates")
ggfacto(ac, interactive = TRUE)
Au survol, chaque modalité affiche son profil : les pourcentages en ligne du tableau croisé, colorés selon l’écart à la moyenne. L’AC dessine la structure des écarts du tableau, sans rien dire de leur intensité : c’est le tableau coloré, à côté, qui la donne.
Analyse des correspondances multiples : profils de réponses et tableau de Burt
Une ACM croise plusieurs questions à la fois. Nous prenons l’enquête
tea de FactoMineR : 300 personnes, 18
questions actives sur leurs façons de boire le thé.
data(tea, package = "FactoMineR")

acm <- multiple_correspondence_analysis(tea, 1:18)
interpret(acm, axes = 1:2)| Question | contrib | Positive_levels | Negative_levels | |||
|---|---|---|---|---|---|---|
| <col%> | <col%> | <col%> | ||||
| Axe 1: 9,9% of variance (mod. 55%) | where | 15.7% | chain store+tea shop | 11.3% | chain store | 4.4% |
| tearoom | 13.9% | tearoom | 11.2% | Not.tearoom | 2.7% | |
| how | 11.2% | tea bag+unpackaged | 6.8% | tea bag | 4.3% | |
| friends | 9.1% | friends | 3.2% | Not.friends | 6.0% | |
| resto | 8.5% | resto | 6.3% | Not.resto | 2.2% | |
| price | 8.1% | p_variable | 3.5% | p_branded | 3.0% | |
| tea.time | 7.2% | tea time | 3.1% | Not.tea time | 4.1% | |
| pub | 5.5% | pub | 4.4% | |||
| work | 4.2% | work | 3.0% | |||
| How | 3.9% | other | 2.3% | |||
| Tea | 3.4% | green | 3.0% | |||
| lunch | 2.8% | lunch | 2.4% | |||
| Above mean ctr | 87.0% | 57.3% | 29.6% | |||
|
Axe 2: 8,1% of variance (mod. 28%) |
where | 28.6% | tea shop | 23.9% | chain store | 4.6% |
| price | 25.6% | p_upscale | 20.5% | p_branded | 2.5% | |
| how | 23.4% | unpackaged | 18.9% | tea bag | 4.5% | |
| Tea | 7.3% | green | 3.3% | Earl Grey | 2.4% | |
| Above mean ctr | 80.5% | 66.6% | 13.9% | |||
|
Contribution to the variance of the axis : a level on the positive side,
contributing ×1 ;
×2 ; ×5 ; ×10 the mean contribution ; a level on
the negative side, contributing ×1 ; ×2 ; ×5 ; ×10 the mean
contribution.
contrib: the whole question’s contribution to the axis |
||||||
| Axe | eigenvalue | % variance | cumul. |
Benzecri’s modified rate |
cumul. mod. |
|---|---|---|---|---|---|
| <var> | <col%> | <col%> | |||
| Axe 1 | 0.148 | 9.9% | 9.9% | 55.4% | 55.4% |
| Axe 2 | 0.122 | 8.1% | 18.0% | 28.1% | 83.4% |
| Axe 3 | 0.090 | 6.0% | 24.0% | 7.6% | 91.1% |
| Axe 4 | 0.078 | 5.2% | 29.2% | 3.3% | 94.3% |
| Axe 5 | 0.074 | 4.9% | 34.1% | 2.1% | 96.5% |
| Axe 6 | 0.071 | 4.8% | 38.9% | 1.6% | 98.1% |
| Axe 7 | 0.068 | 4.5% | 43.4% | 1.0% | 99.1% |
| Axe 8 | 0.065 | 4.4% | 47.7% | 0.6% | 99.7% |
| … of 27 | … | … | … | … | … |
| Total | 1.500 | 100% | 100% |
En ACM, les taux de variance bruts sont faibles par construction : on choisit le nombre d’axes à interpréter sur le taux modifié de Benzécri, dans le tableau des valeurs propres, ici 83 % sur les deux premiers axes. Le premier oppose le thé pris seulement à la maison au thé pris dehors, entre ami·es (salon de thé, restaurant, pub) ; le second, le thé en sachet acheté au supermarché au thé en vrac de boutique spécialisée.
acm <- name_axes(acm, "à la maison / dehors, entre ami·es",
                      "supermarché / boutique de thé")
ggfacto(acm, tea, sup_vars = c(sex, SPC), interactive = TRUE)
La base de données est redonnée en second argument, pour les variables supplémentaires (en italique). Deux choses se lisent au survol :
- les points gris sont les profils de réponses : les personnes qui ont donné exactement les mêmes réponses, leur taille disant leur nombre. Chacun affiche ses réponses ;
- chaque modalité affiche ses tableaux croisés avec toutes les autres questions actives : c’est le tableau de Burt sur lequel l’ACM est calculée, ses écarts à la moyenne colorés. On revient ainsi aux données sans croiser les 18 questions deux à deux.
Classification
La classification ascendante hiérarchique regroupe les individus les
plus proches sur les premiers axes. Sans nb_clust, elle
dessine l’arbre et coupe là où le gain de variance inter-classes
chute.
hierarchical_clust(acm, ncp = 3)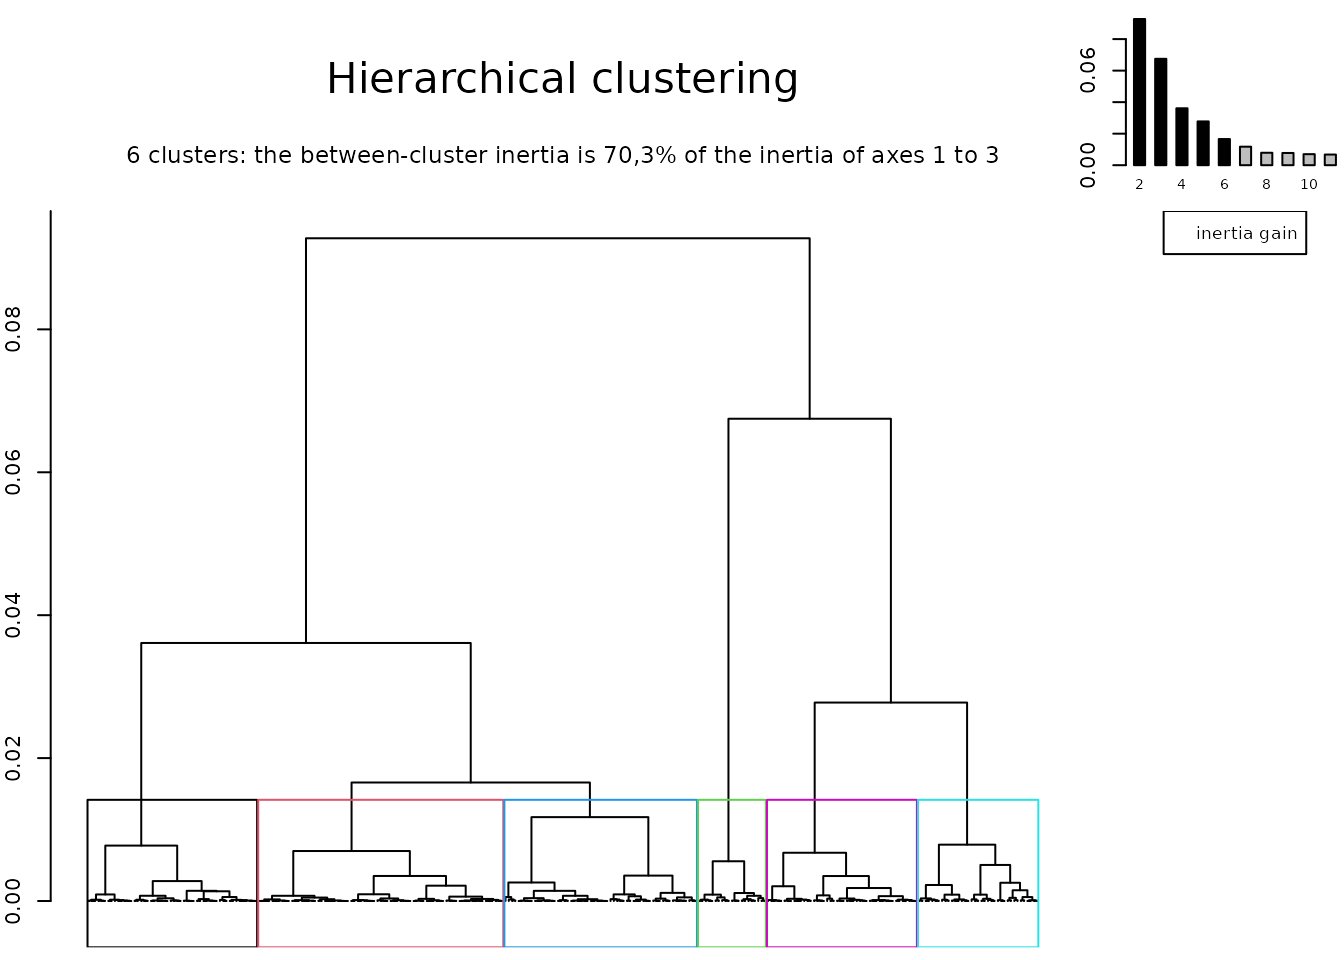
Les classes s’écrivent dans la base avec mutate(),
nommées dans l’ordre voulu ("nom" = numéro) : l’arbre n’est
pas reconstruit.
tea <- tea |>
  mutate(classes = hierarchical_clust(acm, ncp = 3, names = c(
    "Sachets du supermarché" = 1,
    "Earl Grey sucré"        = 2,
    "Earl Grey entre ami·es" = 4,
    "Thé noir sans sucre"    = 5,
    "Boutiques de thé"       = 3,
    "Thé partout"            = 6
  )))

clust_tab(acm, tea, classes)| clust | |||||||
|---|---|---|---|---|---|---|---|
| lvs |
Sachets du supermarché |
Earl Grey sucré |
Earl Grey entre ami·es |
Thé noir sans sucre |
Boutiques de thé |
Thé partout | Ensemble |
| <col%> | <col%> | ||||||
| breakfast | 65% | 12% | 44% | 61% | 44% | 67% | 48% |
| Not.tea time | 49% | 79% | 34% | 15% | 50% | 14% | 44% |
| evening | 10% | 50% | 41% | 30% | 31% | 58% | 34% |
| lunch | 6% | 9% | 23% | 6% | 9% | 39% | 15% |
| dinner | 4% | 11% | 6% | 3% | 22% | 0% | 7% |
| always | 13% | 39% | 39% | 27% | 44% | 64% | 34% |
| home | 100% | 86% | 100% | 100% | 97% | 100% | 97% |
| Not.work | 81% | 88% | 59% | 73% | 78% | 36% | 71% |
| Not.tearoom | 97% | 98% | 89% | 45% | 75% | 39% | 81% |
| friends | 30% | 68% | 86% | 76% | 56% | 100% | 65% |
| Not.resto | 90% | 80% | 66% | 67% | 91% | 33% | 74% |
| Not.pub | 97% | 84% | 70% | 82% | 78% | 44% | 79% |
| black | 39% | 2% | 6% | 73% | 25% | 17% | 25% |
| Earl Grey | 44% | 84% | 92% | 24% | 47% | 81% | 64% |
| green | 16% | 14% | 2% | 3% | 28% | 3% | 11% |
| alone | 61% | 88% | 67% | 52% | 69% | 44% | 65% |
| lemon | 4% | 9% | 9% | 6% | 19% | 31% | 11% |
| milk | 35% | 4% | 20% | 24% | 12% | 22% | 21% |
| other | 0% | 0% | 3% | 18% | 0% | 3% | 3% |
| No.sugar | 63% | 18% | 50% | 85% | 56% | 47% | 52% |
| tea bag | 84% | 82% | 64% | 24% | 9% | 17% | 57% |
| tea bag+unpackaged | 15% | 12% | 31% | 61% | 19% | 81% | 31% |
| unpackaged | 1% | 5% | 5% | 15% | 72% | 3% | 12% |
| chain store | 95% | 96% | 67% | 33% | 6% | 19% | 64% |
| chain store+tea shop | 5% | 0% | 31% | 67% | 9% | 81% | 26% |
| tea shop | 0% | 4% | 2% | 0% | 84% | 0% | 10% |
| p_branded | 49% | 50% | 27% | 9% | 6% | 17% | 32% |
| p_cheap | 4% | 5% | 2% | 0% | 0% | 0% | 2% |
| p_private label | 15% | 11% | 2% | 3% | 0% | 3% | 7% |
| p_unknown | 5% | 7% | 5% | 0% | 0% | 3% | 4% |
| p_upscale | 5% | 5% | 3% | 45% | 81% | 8% | 18% |
| p_variable | 22% | 21% | 62% | 42% | 12% | 69% | 37% |
| % of population | 26% | 19% | 21% | 11% | 11% | 12% | 100% |
| n | 79 | 56 | 64 | 33 | 32 | 36 | 300 |
|
Percentage points (risk) difference : cell ≥ the Total column +5 ; +10 ; +20 ; +30 points ; cell ≤ the Total column
-5 ; -10 ; -20 ; -30 points.
|
|||||||
Le tableau décrit chaque classe par les variables actives, pondérées comme l’analyse, les écarts à l’ensemble colorés. Le graphique place les classes dans le nuage, leurs individus colorés :
ggfacto(acm, tea, clust = classes)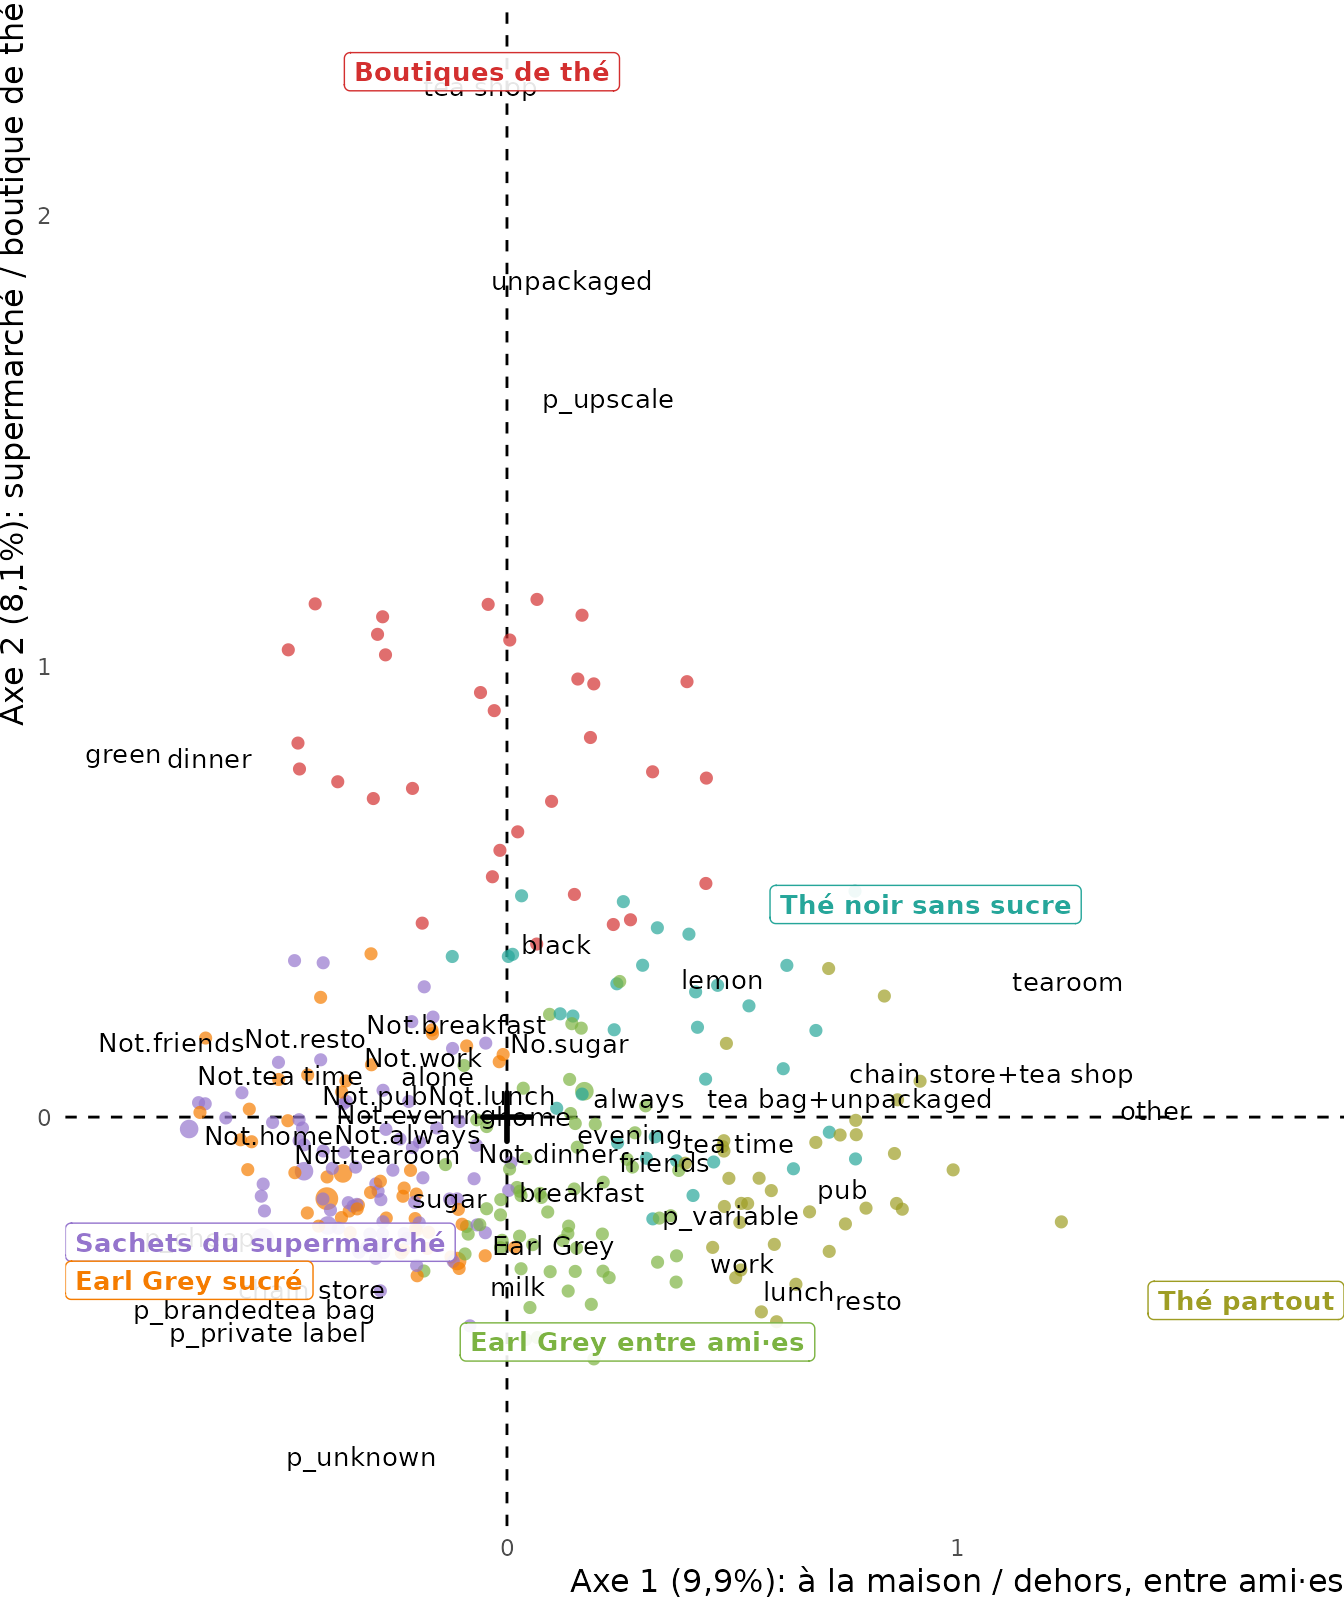
Pour aller plus loin
-
Pondération :
wt =dans les trois analyses ; les poids passent jusqu’aux tableaux des bulles d’information. -
ACM spécifique :
excl =écarte des modalités (par défaut, les valeurs manquantes) ; sous-population :filter =, oufilter()dans le pipe, puis la base entière redonnée àggfacto(). -
Graphiques : ce sont des
ggplot, que l’on complète avec+avantggi();ggsave2()les enregistre ;ggmca_3d()etggpca_3d()les dessinent en trois dimensions. - Les coordonnées des individus s’ajoutent à la base avec
mutate(axe1 = axis_coord(acm, 1)), comme les classes.
La référence détaille chaque fonction.